Robots footballeursBrève
Un robot NAO apprend à marquer au football en 30 minutes, 100 % de réussite selon les chercheurs
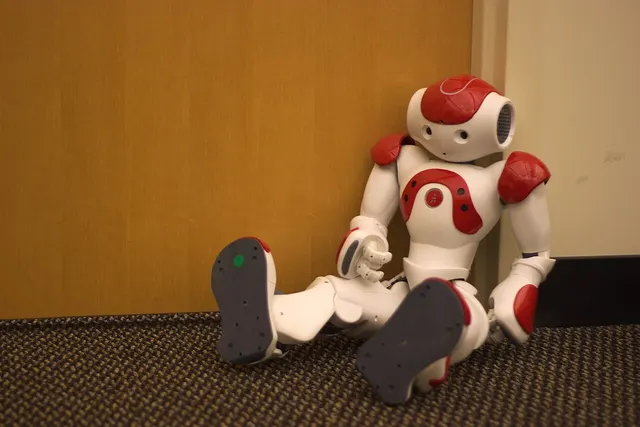
Dans un article publié sur arXiv, une équipe de chercheurs décrit comment un robot bipède apprend, par essais et erreurs, à pousser un ballon jusqu'au but.
Selon le résumé des auteurs, le robot apprend à marquer depuis plusieurs positions de départ après 30 minutes d'interaction dans le monde réel. Il atteint 100 % de réussite, contre 0 % pour une politique dite « feed-forward » entraînée avec le même budget. Le résumé ne précise pas sur combien d'essais ces taux sont mesurés.
Le robot se débrouille avec ses propres capteurs. Les chercheurs estiment toutes les variables utiles à bord, avec un filtre de Kalman, sans système de capture de mouvement ni caméras placées au-dessus du terrain.
Ce filtre peut se tromper quand le ballon n'est pas observé. Les auteurs ajoutent donc un modèle appris qui ne corrige sa représentation interne que lorsque le ballon est observé.
Les chercheurs ont complété les essais sur le robot par une étude en simulation. D'après eux, leur méthode, baptisée RSSM-RLPD, y obtient un meilleur taux de réussite que l'apprentissage par imitation et que deux autres méthodes de référence.
L'article a été soumis à la conférence de robotique ICRA 2027.
Source
- arXiv (cs.RO, robotique) · arxiv.org